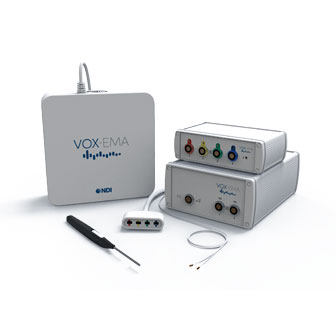
加拿大 NDI 电磁发音追踪系统 Vox-EMA
Vox-EMA 是 Northern Digital Inc.(NDI)的电磁发音(EMA)追踪系统,该公司总部位于加拿大安大略省滑铁卢 103 Randall Drive。该型号已非现行产品:ndigital.com 上原有的 Vox-EMA 产品页已下线,NDI 现行产品页面仅覆盖 Polaris 光学跟踪系列与 Aurora、3D Guidance 电磁跟踪系列,官方未给出 Vox-EMA 的替代型号;官网页脚仍保留 Legacy Products(遗留产品)入口,销售与支持联系由总部及 NDI 在中国香港、德国、美国的办事处承担。厂商称其提供精密设计的光学与电磁跟踪技术,涵盖从元器件到可集成平台,面向 OEM 医疗器械集成。
仪器信息
| 品牌 | NDI |
|---|---|
| 型号 | Vox-EMA |
| 分类 | 三维电磁发音仪 |
| 仪器编码 | canada-ndi-electromagnetic-articulography-tracking-system-vox-ema |
| 在售状态 | 停售 |
| 地区来源 | 加拿大 |
| 更新时间 | 2026-10-10 |
| 研究领域 | 言语产生研究、临床语音学与言语病理学、言语运动控制与感觉运动整合、头颈肿瘤术后言语功能与康复结局研究、神经退行性疾病(帕金森病)言语研究 |
技术参数
共 56 条规格记录
| 产品状态 | 已停产 |
|---|---|
| 产品发布年份 | 2020 年 |
| 产品代际关系 | NDI Wave System(2008 年发布)的后继系统 |
| 产品形态 | 便携式系统 |
| 系统构成 | 磁场发生器(FGU)、系统控制单元(SCU)、传感器接口单元(SIU)、传感器线束组件(SHA)、传感器(S1–S16) |
| 系统控制单元数量 | 1 个(使用 16 个传感器时) |
| 传感器接口单元数量 | 2 个 |
| 传感器线束组件数量 | 2 套(配齐 16 个传感器时) |
| 连接标识方式 | 全部连接均有明确标记并采用颜色编码 |
| 测量原理 | 电磁发音跟踪(electromagnetic articulography,EMA) |
| 信号检测原理 | 磁场发生器内不同朝向的频闪发射线圈在传感器中感应电流,通过测量感应电流并参照已知电磁场特性,由专有软件解算各传感器的空间位置与朝向 |
| 测量对象 | 声道内传感器的位置(发音器官运动) |
| 5DOF 传感器测量自由度 | 三维位置坐标(x、y、z)与两个角度坐标(绕 x 轴与 y 轴旋转) |
| 6DOF 传感器测量自由度 | 在 5DOF 基础上增加绕 z 轴旋转的第三个角度坐标 |
| 激励场工作频率 | 3.2 kHz(磁场发生器) |
| 通道数 | 最多 16 个 |
| 最大同时跟踪传感器数量 | 最多 16 个 |
| 最大同时跟踪传感器数量 | 最多 8 个 |
| 传感器混合配置上限 | 16 个 5DOF 传感器,或 14 个 5DOF 传感器加 1 个 6DOF 传感器(6DOF 传感器占用两个传感器端口) |
| 采样率 | 100 Hz、200 Hz、400 Hz |
| 高速采样支持方式 | 标配支持,无需高速升级 |
| 测量空间范围 | 圆顶形(dome),660 mm |
| 测量空间相对磁场发生器的偏移距离 | 50 mm |
| 校准要求 | 无需执行校准程序 |
| 网络与数据传输接口 | 支持 TCP/IP 可访问服务器 |
| 系统控制单元传感器接口端口数 | 2 个(每个系统控制单元) |
| 单套传感器线束组件可接传感器数 | 8 个 |
| 工作站 USB 接口要求 | 系统配置中每个 SCU 1 个 |
| 第三方硬件集成支持范围 | Optotrak Certus(NDI);麦克风 |
| 传感器尺寸 | 长 7.3 mm,直径 2.3 mm |
| 传感器形态 | 圆盘式(disc),直接插入传感器接口单元,被系统识别为单个传感器 |
| 传感器连接方式 | 插入式,一对传感器插入传感器线束组件的一个插槽 |
| 传感器供应形式 | 成对提供 |
| 传感器复用性 | 可重复使用 |
| 传感器导线长度 | 约 1 m |
| 传感器导线重量 | 6 g |
| 传感器线束组件长度 | 2.5 m |
| 传感器线束组件重量 | 200 g |
| 腭部描迹工具配置 | 提供单独的 6D 腭部描迹工具(6D palate trace tool) |
| 配套软件 | VOX-VRI |
| API 提供形式 | 包含示例应用程序代码 |
| 第三方编程环境兼容性 | 支持(如 MATLAB、Python) |
| 操作系统兼容性 | Windows 7 / 10 64 位 |
| 工作站处理器要求 | 英特尔酷睿 i7-4770,CPU @ 3.4 GHz |
| 工作站内存要求 | 8 GB RAM |
| 工作站存储空间要求 | 250 GB |
| 工作站显卡要求 | 建议使用 NVIDIA 显卡和驱动程序 |
| 工作站音频输入要求 | 立体声音频输入(可选) |
| 旋转坐标表示形式 | 欧拉角(Euler angles)或四元数(quaternions)(使用 VOX-VRI 软件时) |
| 原始数据开放性 | 不向用户开放 |
| 传感器标签管理功能 | 支持为传感器指定名称与颜色标签,并可保存供后续实验使用,系统或笔记本电脑重启后仍保留(使用 VOX-VRI 软件时) |
| 音频与运动数据同步功能 | 支持 |
| 磁场发生器尺寸 | 200 mm × 200 mm × 70 mm |
| 磁场发生器重量 | 2.2 kg |
| 磁场发生器支架重量 | 约 5 kg |
| 散热方式 | 无风扇 |
相关实验室
以下机构来自本仪器关联论文的作者署名,不代表已确认采购或持有该仪器。
格罗宁根大学医学中心
地区:荷兰
署名作者:托马斯·B·蒂恩坎普、黛芙妮·阿布尔、特亚·雷贝尔尼克、马丁·维林
研究方向:电磁发音仪、发音工作空间、运动范围、口腔鳞状细胞癌
关联论文 3 篇
哈斯金斯实验室
地区:荷兰
署名作者:马丁·维林
研究方向:听觉反馈扰动、共振峰扰动、言语感觉运动控制、电磁发音仪
关联论文 1 篇
实验方法
研究方向:舌、下颌与唇的三维发音运动学测量、发音工作空间与运动范围(ROM)量化、听觉反馈扰动与发音的感觉运动控制、口腔鳞状细胞癌手术治疗后的言语结局评估、声学—运动学元音空间同步分析、帕金森病口舌运动与震颤评估
基于 Vox-EMA 的口腔癌术后患者句子级发音工作空间与运动范围测量实验
方法说明:本实验使用加拿大 NDI 三维电磁发音仪 Vox-EMA,以 400 Hz 采样率对口腔鳞状细胞癌手术治疗患者(ITOC)与健康对照说话人朗读连续语句时舌尖、舌后与下颌的三维运动进行实时追踪,并同步录制声学信号。通过对头动校正后的传感器坐标计算二维发音工作空间(AWS,mm²)、前后向运动范围(AP-ROM,mm)与上下向运动范围(SI-ROM,mm),量化术后舌与下颌在连续言语中的活动度受限程度,并考察其与言语障碍指数(SHI)自评得分及肿瘤部位(舌部 vs. 下颌部)的关系。该方法把临床上依赖目测、直尺或 Likert 量表的舌活动度评估,转换为可在连续言语任务中获得的毫米级连续量化指标。
实验仪器:三维电磁发音仪 Vox-EMA;枪式电容麦克风 ME66;SPRAAKLAB 移动语音实验室;咬合板与量角器记录装置
实验步骤
- 受试者纳入与伦理审批
说明:从口腔癌 EMA 语料库中选取九名接受舌部或下颌部肿瘤手术治疗的荷兰语母语患者与八名年龄、性别匹配的对照说话人,全部签署书面知情同意书。
关键点:纳入标准要求术后至少满一年、无神经或言语障碍史、头部及口腔内无医用钛以外的不可拆卸金属,以避免电磁场受到干扰。
- 传感器粘贴与参考点布置
说明:粘贴五个测量传感器:下门齿(下颌)一枚、舌部两枚(舌尖传感器置于舌解剖尖端后约 1 cm,舌后传感器置于 /k/ 成阻位置)、上下唇唇红缘各一枚。
关键点:另布置四个参考传感器(左右乳突、鼻梁、上门齿)用于校正头部运动;传感器在组块之间需检查粘附情况,同一分析应尽量取自同一录音组块以控制重贴带来的位置差异。
- 咬合板与腭部轨迹采集
说明:使用带三枚传感器与量角器的咬合板为每位说话人做一次咬合平面记录,并用贴在受试者拇指上的备用传感器描绘硬腭轮廓。
关键点:咬合板记录用于把头动校正后的坐标旋转到统一的咬合平面坐标系,是跨说话人可比性的前提。
- 语音任务录制
说明:在 SPRAAKLAB 移动实验室的隔声车厢内,受试者朗读荷兰语版《北风与太阳》短文(8 句、8—26 词),Vox-EMA 以 400 Hz 采集运动学数据,Sennheiser ME66 枪式麦克风以 22050 Hz 同步采集声学信号。
关键点:移动实验室可停放于大学或受试者住所,降低术后患者出行负担;选取录制时间靠前的组块可减少传感器脱落与疲劳效应。
- 数据预处理与坐标变换
说明:在 MATLAB 2020a 中对全部数据做头动校正与咬合平面旋转,人工检查每条录音,剔除首尾静音与可听见的吞咽段,朗读出错并重读的句子仅保留正确的一遍。
关键点:舌尖与舌后传感器数据需减去下颌运动以解耦,从而直接评估舌自身的运动贡献。
- 运动学指标计算
说明:对每条语句用 MATLAB 的 convhull() 函数计算舌尖、舌后与下颌传感器的二维凸包面积得到 AWS;用 X(前后向)与 Z(上下向)坐标的极大值与极小值之差得到 AP-ROM 与 SI-ROM。
关键点:共获得 17 位说话人 × 8 句 = 136 个数据点,其中一个下颌 AWS 数据点因传感器追踪可疑被剔除,最终保留 135 个数据点。
- 统计建模与自评关联分析
说明:在 R 4.1.3 中用 lme4/LmerTest 拟合线性混合效应模型(结局变量 z 标准化,固定效应为传感器×组别与性别,随机效应含句子与说话人),并用 Spearman 秩相关检验 AWS 与 SHI 的关系。
关键点:用 boot 包 1000 次自举计算 95% 置信区间;因临床样本仅 9 人,相关分析采用非参数检验并以效应量(|rs| ≥ .4)而非显著性作为解释门槛。
实验数据
传感器三维位置时间序列
数据来源:Vox-EMA 以 400 Hz 采集的舌尖、舌后、下颌、上下唇及四个参考传感器坐标
实验样本:每帧含各传感器的 X(前后)、Y(左右)、Z(上下)坐标(单位 mm),经头动校正与咬合平面旋转后输出
数据呈现:以前后向为横轴、上下向为纵轴绘制传感器运动散点与凸包轮廓图,按传感器着色
二维发音工作空间 AWS
数据来源:由每条语句的传感器坐标凸包面积计算得到
实验样本:舌尖 AWS 男性约 0—400 mm²、女性约 0—250 mm²;舌后 AWS 男性约 0—600 mm²;下颌 AWS 约 0—120 mm²
数据呈现:按性别分面的箱线图叠加个体散点,并以灰色虚线标示对照组均值
一维运动范围 AP-ROM 与 SI-ROM
数据来源:同一语句内传感器前后向与上下向坐标的极大值减极小值
实验样本:舌尖、舌后 AP-ROM 约 4—30 mm;SI-ROM 约 5—35 mm
数据呈现:按性别与组别分面的箱线图配合个体数据点
同步声学信号
数据来源:Sennheiser ME66 枪式麦克风,采样率 22050 Hz,置于受试者口部约 20 cm 处
实验样本:与运动学数据时间对齐的单通道语音波形,用于句子切分与静音剔除
数据呈现:波形与语图对照显示,配合人工标注边界
言语障碍指数 SHI 自评得分
数据来源:荷兰语 15 条目版 Speech Handicap Index 问卷
实验样本:总分 0—60;本研究患者样本均值 17.9(SD = 9.4),对照参考均值约 5
数据呈现:个体 SHI 得分与各传感器 AWS 均值的散点图并附趋势线
方法关联论文:用电磁发音仪量化口腔癌手术治疗者的发音工作空间
Vox-EMA 与听觉共振峰扰动同步的发音运动学—声学响应实验
方法说明:本实验在帕金森病患者(IwPD)与对照说话人中,采用可预期(渐变)与非预期(突变)两种元音共振峰扰动范式,考察言语发音的感觉运动控制。受试者佩戴头戴麦克风朗读目标词,其嗓音经 Audapter 实时改变第一、第二共振峰后由耳机回放;与此同时用加拿大 NDI 的 Vox-EMA 三维电磁发音仪同步采集舌尖、舌体与下颌的运动轨迹。通过把运动学轨迹与人工标注的元音区间时间对齐,再用广义可加混合模型(GAMM)拟合试次进程或元音起始后 400 ms 的轨迹,可分别刻画适应性(前馈更新)响应与反射性(反馈纠错)响应,并比较患者与对照在声学与运动学两个层面的差异。
实验仪器:三维电磁发音仪 VOX-EMA;头戴式麦克风 MX153;入耳式监听耳机 IE 100 PRO;隔声实验舱
实验步骤
- 受试者筛查与分组
说明:招募 33 名服用左旋多巴的帕金森病患者与 25 名对照说话人,完成蒙特利尔认知评估(MoCA)、年龄适配纯音听力筛查与 MDS-UPDRS 第 I—III 部分评定。
关键点:所有患者均在服药(ON)状态下完成任务以保证生态效度;MoCA 达到 22/30 方可纳入,确保具备知情同意能力。
- EMA 传感器布置与坐标校准
说明:在舌尖(距舌尖端 1 cm)、舌体(/k/ 成阻处)与颏部(追踪下颌)各贴一枚测量传感器,另设左右乳突与上门齿参考传感器;全部任务在隔声房间内完成。
关键点:用会话开始时采集的咬合板记录把坐标旋转到咬合平面;舌体传感器易脱落,需按可用传感器情况划分全体样本与完整样本两套分析。
- 可预期共振峰扰动任务
说明:受试者朗读含 /ɛ/ 的六个目标词共 120 试次:24 试次基线、24 试次渐变加载至 F1 −20%、F2 +15%、48 试次保持、24 试次撤除扰动的后效阶段。
关键点:同时扰动第一与第二共振峰更接近真实言语错误感知,更易诱发较大的适应性响应;试次间隔约 5 s,每个元音时长要求不少于 100 ms。
- 非预期共振峰扰动任务
说明:受试者重复朗读六个目标词共 120 次,其中 15 次向上扰动(F1 −20%、F2 +15%)、15 次向下扰动(F1 +20%、F2 −15%)、90 次不扰动,扰动在发声起始时随机触发。
关键点:每个扰动试次前至少有一个不扰动试次,以抑制学习效应;要求元音时长不少于 500 ms,以完整捕捉出现在扰动后 100—200 ms 的反射性响应。
- 实时扰动与音频回放
说明:使用 Shure MX153 头戴麦克风采声,Audapter 2.1 在 MATLAB 2020a 中实时完成共振峰移频,经 Sennheiser IE 100 PRO 入耳式耳机以相对自身语音 +5 dB 的增益回放。
关键点:+5 dB 的放大用于掩蔽骨导听觉反馈,确保受试者听到的主要是被扰动后的声音。
- 数据预处理与声学—运动学对齐
说明:三名研究者在 Praat 6.3.15 中人工标注全部试次并用脚本提取共振峰;EMA 运动学数据先按三个参考传感器做头动校正并旋转至咬合平面,再用自编 R 脚本按人工标注的元音区间与声学数据配对。
关键点:所有传感器坐标依据声学设定的时间界标提取,保证运动学取值与共振峰测量落在同一时间窗内。
- 响应量化与统计建模
说明:可预期任务取元音 20%—60% 区间(不超过前 200 ms)的均值;非预期任务以 5 ms 步长保留元音前 400 ms 轨迹;数据按不扰动试次均值与标准差做 z 标准化后用 mgcv 拟合 GAMM。
关键点:GAMM 可对非线性响应曲线建模,并用组别二元差异平滑检验患者与对照在试次进程或时间轨迹上的差异;残差偏厚尾时改用 scaled-t 分布拟合。
实验数据
舌尖、舌体与下颌运动轨迹
数据来源:NDI Vox-EMA 三维电磁发音仪同步采集的测量传感器坐标
实验样本:TTx/TTy(舌尖前后与高度)、TBx/TBy(舌体前后与高度)、JAWx/JAWy(下颌前后与高度),单位为毫米,非预期任务保留元音起始后 0—400 ms、步长 5 ms 的序列
数据呈现:以试次序号或元音内时间为横轴绘制 GAMM 拟合曲线及置信带,按组别与扰动条件着色
第一、第二共振峰时程
数据来源:Shure MX153 头戴麦克风录制、Praat 人工标注后脚本提取
实验样本:以赫兹为单位的 F1、F2 值;可预期任务取元音 20%—60% 区间均值,非预期任务取 400 ms 逐帧序列
数据呈现:共振峰随试次变化的折线图与元音内时间轨迹图,标注基线、渐变、保持与后效四阶段
施加的扰动量
数据来源:Audapter 实时扰动参数记录
实验样本:可预期任务最大 F1 −20%、F2 +15%;非预期任务向上 F1 −20%、F2 +15%,向下 F1 +20%、F2 −15%
数据呈现:扰动百分比随试次或时间变化的示意曲线图
临床与感知评定数据
数据来源:MDS-UPDRS 第 III 部分评分、运动表型分类、纯音听力筛查、41 名非专业听者的言语严重度视觉模拟量表评分与患者自评问卷
实验样本:MDS-UPDRS III 男性均值 38 分、女性 36 分;言语严重度评分为 1—100 的连续值;自评项目按发音与嗓音各 6 分计
数据呈现:受试者层面的表格与分组分布图
方法关联论文:帕金森病与非帕金森病说话人对可预期与非预期听觉反馈扰动的运动学与声学响应
声学—运动学—感知—自评多域同步评估实验(AAVS 与 AKVS)
方法说明:本实验用 NDI-Vox 三维电磁发音仪与麦克风对同一批口腔癌术后患者与对照说话人做声学与运动学同步采集,在句子层面分别计算基于共振峰轨迹的发音—声学元音空间(AAVS,mels²)和基于舌尖、舌后传感器轨迹的发音—运动学元音空间(AKVS,mm²),再结合非专业听者的可懂度与听辨努力视觉模拟量表评分以及患者的言语障碍指数自评,形成覆盖客观与主观四个域的评估体系,并分析各域指标在说话人之间与说话人内部的关联结构。
实验仪器:三维电磁发音仪 NDI-Vox;枪式电容麦克风 ME66;音频接口声卡 US 4×4;监听耳机 HD 280 Pro;色转移涂药棒 Dr. Thompson's;SPRAAKLAB 移动语音实验室
实验步骤
- 说话人选取与样本描述
说明:从口腔癌 EMA 语料库中选取九名接受舌部或下颌部肿瘤手术的患者与八名年龄、性别匹配的对照说话人,全部为荷兰语母语者。
关键点:术后时长平均 5.1 年(范围 1.2—11.4 年);只纳入具有可用运动学数据的说话人。
- 同步声学与运动学录制
说明:在 SPRAAKLAB 移动实验室内,用 Sennheiser ME66 枪式麦克风(22050 Hz,经 Tascam US 4×4 声卡数字化)采声,同时用 NDI-Vox 发音仪以 400 Hz 通过 MATLAB 接口连接 VOX-VRI 记录软件采集运动学数据。
关键点:两路数据时间对齐是后续同框架比较 AAVS 与 AKVS 的前提;共布置五个测量传感器,本研究只取与元音产生最相关的两个舌传感器。
- 舌传感器定位与腭部成阻点标定
说明:舌尖传感器置于舌解剖尖端后 1 cm,舌后传感器置于说话人的 /k/ 成阻位置;用色转移涂药棒让受试者发 /k/,以着色痕迹确定舌与腭接触形成成阻的位置。
关键点:同时布置左右乳突、鼻梁与左上门齿牙龈四个参考传感器过滤头动,并做咬合板记录以旋转至咬合平面。
- 朗读任务
说明:所有说话人在佩戴 EMA 传感器状态下朗读荷兰语《北风与太阳》短文(8 句、8—26 词,平均 14.6 词)。
关键点:选用该短文因其在临床语言学中通用、便于跨研究比较,且录制时间靠前可降低传感器脱落与疲劳影响。
- 声学分析:AAVS 计算
说明:在 Praat 6.3.1 中剔除清音段,按 5 ms 步长、25 ms 窗在 3500—6000 Hz 共振峰上限范围内迭代提取 F1、F2,取最优共振峰上限对应的中位值,剔除偏离均值 2 个标准差的离群值,再在 R 中把赫兹转为 mel 并按既有公式求 AAVS。
关键点:AAVS 基于整条语句所有浊音段的 F1—F2 轨迹范围,无需人工切分角元音,适用于连续言语。
- 运动学分析:AKVS 计算
说明:在 mview 中剔除语句前后静音与可听吞咽段,用 MATLAB 提取舌尖与舌后传感器的前后向与上下向坐标并导入 R,按与 AAVS 相同的流程计算以平方毫米为单位的 AKVS。
关键点:考虑到舌与下颌解耦的复杂性及整个声道构型对声学的共同作用,舌尖与舌后数据未与下颌解耦;每个指标获得 136 个数据点(17 位说话人 × 8 句)。
- 感知评测与自评问卷
说明:35 名通过听力筛查的非专业听者在 MATLAB 图形界面中用两条 100 mm 视觉模拟量表对每条语句评定可懂度与听辨努力,刺激混入信噪比 +2 dB 的多人杂音,通过 Sennheiser 280 Pro 耳机以 65—70 dB SPL 呈现;患者另完成 15 条目荷兰语 SHI 自评。
关键点:每条语句由两至三名听者评分,随机重复 3 条刺激以评估评分者内一致性(ICC);加入杂音以模拟更自然的交际条件、降低天花板效应。
- 跨域关联统计
说明:先比较患者组与对照组在 AAVS、AKVS 与可懂度上的差异,再在患者组内计算声学、运动学、感知、自评四域指标的相关矩阵,并区分说话人之间与说话人内部两个层次。
关键点:组间关系与说话人内部关系可以分离:声学与运动学在群体层面关联不强,但在个体内部关联更强,提示说话人特异的代偿策略。
实验数据
发音—运动学元音空间 AKVS
数据来源:NDI-Vox 采集的舌尖(TT)与舌后(TB)传感器前后向与上下向坐标轨迹
实验样本:AKVS-TT 与 AKVS-TB,单位为平方毫米,每个指标 136 个数据点(17 位说话人 × 8 句)
数据呈现:按组别分面的箱线图与个体散点图,并与对应的 AAVS 值做散点对照
发音—声学元音空间 AAVS
数据来源:同步录制的声学信号,经 Praat 自动脚本提取 F1、F2 轨迹后计算
实验样本:以 mels² 为单位的句级取值;共振峰轨迹按 5 ms 步长采样,误追踪点剔除率为 0.06%(45 个数据点)
数据呈现:按组别与说话人绘制的分布图,以及与 AKVS、可懂度的相关散点图
可懂度与听辨努力评分
数据来源:35 名非专业听者在视觉模拟量表上的评定
实验样本:可懂度 0(完全不可懂)至 100(完全可懂);听辨努力 0(毫不费力)至 100(极度费力);共 136 个句级均值数据点
数据呈现:按组别的评分分布图与个体均值排序图
言语障碍指数 SHI 自评得分
数据来源:荷兰语 15 条目 Speech Handicap Index 问卷,5 点 Likert 计分
实验样本:总分 0—60,分值越高表示自评言语问题越重;对照参考均值约 5 分
数据呈现:个体得分与各客观指标的散点图
方法关联论文:口腔癌手术治疗者言语的声学、运动学、自评与感知指标之间的关联
主要部件
暂未收录主要部件
相关论文
共 3 篇;当前显示第 1 页
帕金森病与非帕金森病说话人对可预期与非预期听觉反馈扰动的运动学与声学响应
原文题名:Kinematic and Acoustic Responses to Predictable and Unexpected Auditory Feedback Perturbations in Speakers With and Without Parkinson's Disease
发表年份:2026
作者:特亚·雷贝尔尼克;托马斯·B·蒂恩坎普;萨沙·查博克萨瓦尔;尼基·胡克泽马;瓦伦蒂娜·乔特;卡塔琳娜·波尔斯特雷尔;安妮特耶·格莱克曼;鲁尔·扬克斯;奥德·努瓦雷;黛芙妮·阿布尔;马丁·维林
刊源:Journal of Speech, Language, and Hearing Research
DOI 10.1044/2025_JSLHR-24-00697查看论文摘要与书目信息
摘要 · 中文整理:目的:帕金森病患者(IwPD)常出现导致可懂度下降的发音障碍。以往研究虽已考察听觉反馈与前馈机制,但多仅使用声学指标,可能不足以捕捉细微变化。本研究通过测量受试者说话时对可预期或非预期听觉反馈误差的声学与运动学响应,评估 IwPD 与对照说话人(CS)的言语发音感觉运动控制。方法:采用两种共振峰扰动任务,即可预期(向上)元音扰动任务与非预期(向上与向下)元音扰动任务。33 名服用左旋多巴的 IwPD 与 25 名 CS 完成任务,语音同时经麦克风做声学记录、经贴于舌与下颌的传感器做运动学记录。使用广义可加建模分析声学(第一、第二共振峰频率)与运动学(下颌及舌的高度与前后位置)响应。结果:在可预期扰动任务中,IwPD 与 CS 的运动学与声学响应无差异;在非预期扰动任务中,两组在向下扰动条件下的声学与运动学均存在差异,向上扰动则无差异。对非预期向下扰动,当以第二共振峰与舌体高度建模元音轨迹时,IwPD 的响应比 CS 更慢且幅度更小。结论:IwPD 在声学与运动学两方面纠正非预期听觉反馈误差的能力下降,但仍保留基于可预期误差更新言语感觉运动映射的能力。本研究通过揭示言语发音感觉运动控制中的潜在差异,拓展了对帕金森病言语与语言损害的评估。
原文摘要:Purpose: Individuals with Parkinson's disease (IwPD) frequently suffer from speech articulation impairments that result in reduced intelligibility. While some studies have previously investigated auditory feedback and feedforward mechanisms as potential explanations behind these impairments, they have done so using only acoustic measures, which may not be sensitive enough to capture small changes. The current study assessed the sensorimotor control of speech articulation in IwPD and control speakers (CS) by measuring both acoustic and kinematic responses to either predictable or unexpected errors in auditory feedback while participants were speaking. Method: We employed two formant perturbation tasks: a predictable (upward) vowel perturbation task and an unexpected (upward and downward) vowel perturbation task. A total of 33 IwPD on levodopa and 25 CS performed the tasks, while their speech was recorded acoustically with a microphone and kinematically with sensors placed on the tongue and the jaw. We analyzed acoustic (first and second formant frequencies) and kinematic (jaw and tongue height and backness) correlates of vowel perturbation task responses using generalized additive modeling. Results: In the predictable vowel perturbation task, IwPD and CS did not differ in their responses in kinematic or acoustic measures. In the unexpected vowel perturbation task, we found differences between the two groups in both acoustics and kinematics for the downward perturbation, but not for the upward perturbation. For the unexpected downward perturbation, IwPD responded more slowly and to a lesser degree than did CS when vowel trajectories were modeled using the second formant and kinematic tongue body height. Conclusions: IwPD showed a reduced ability to correct unexpected errors in auditory feedback both acoustically and kinematically but retained the ability to update their speech sensorimotor maps based on predictable errors in auditory feedback. This study expands on existing assessments of language- and speech-related impairments in Parkinson's disease by highlighting important potential differences in sensorimotor control of speech articulation.
关键词:听觉反馈扰动、共振峰扰动、言语感觉运动控制、电磁发音仪、帕金森病、广义可加混合模型
研究目标:帕金森病言语障碍的成因中,前馈控制与反馈控制各自的贡献尚不清楚;既往共振峰扰动研究仅记录声学响应,无法分辨说话人是否使用了声学上不可见的代偿性发音策略。本文要解决的是如何在扰动范式中同步获取运动学证据,从而区分患者在可预期扰动下的运动学习能力与在非预期扰动下的即时纠错能力。
主要结论:帕金森病患者对可预期扰动的适应性响应与对照组无差异,说明其基于稳定误差更新内部模型的能力得以保留;但在非预期向下扰动条件下,患者的声学与舌体运动学纠正响应更慢、幅度更小,提示其即时整合听觉反馈并执行快速纠错的能力受损。这一差异在仅有声学指标时难以完整揭示。
创新点:首次把 Vox-EMA 三维发音运动追踪与可预期、非预期两类元音共振峰实时扰动范式结合,在同一批帕金森病患者中同时获取声学与运动学响应,并用广义可加混合模型对元音内 400 ms 轨迹做非线性建模,从而把前馈与反馈两类控制机制的损伤分离开来。
后续建议:改进舌体传感器粘附工艺或增加备份传感器,减少因脱落导致的运动学数据缺失与样本分层;增加关(OFF)药状态测试,评估左旋多巴对反馈纠错能力的具体作用;将扰动方向扩展到更多元音与辅音成阻目标,检验结论在不同发音目标上的普适性;结合运动表型(震颤型与姿势不稳/步态障碍型)与疾病严重度做分层分析;把运动学响应指标与可懂度、言语严重度评分关联,评估其作为临床疗效指标的潜力
APA 引文:Rebernik, T., Tienkamp, T., Chaboksavar, S., Hoekzema, N., Ciot, V., Polsterer, K., Gleichman, A., Jonkers, R., Noiray, A., Abur, D., & Wieling, M. (2026). Kinematic and acoustic responses to predictable and unexpected auditory feedback perturbations in speakers with and without Parkinson's disease. Journal of Speech, Language, and Hearing Research, 69(4), 1469–1489. https://doi.org/10.1044/2025_JSLHR-24-00697
仪器引用:Kinematic data were simultaneously collected using the Northern Digital Inc. VOX-EMA electromagnetic articulograph (Rebernik, Jacobi, Tiede, & Wieling, 2021). We used five movement sensors on the tongue tip, placed 1 cm from the apex; the tongue body, placed at the /k/ constriction; chin (to track jaw movements; hereinafter JAW), and upper and lower lips.
使用资料与操作视频
Opti-Speech-VMT_ Implementation and Evaluation
发布时间:2023-10-24T01:39:07Z
Multimodal Speech_ from articulatory speech to audiovisual speech
发布时间:2023-10-24T01:33:23Z
Articulatory-to-Acoustic conversion using BiLSTM-CNN word-attention-based method
发布时间:2023-10-18T03:56:12Z
Analyzing vocal tract movements during speech accommodation
发布时间:2023-10-18T03:52:47Z