英国 icSpeech 便携式鼻音测量系统 Nasality Microphone
icSpeech Nasality Microphone 是英国 Rose Medical Solutions Ltd 的便携式 USB 鼻音测量系统,在售。 置于上唇上方的隔离板装有指向性鼻腔与口腔麦克风;鼻化度=鼻腔声能/(鼻腔+口腔声能)×100,仅对浊音计算。 驻极体电容麦克风,100-15,000 Hz(滤波后 350-650 Hz),1 kHz 时 -40 dB;USB 适配器 16 位、最高 48 kHz;免校准;支持 Windows 10/11。 用于腭裂、腭咽功能障碍、鼻音过高与过低人群的鼻化度测量及视觉生物反馈。 标配:隔离板、两只麦克风、四个防风罩、把手、USB 适配器、USB 数据卡、便携箱、用户手册;NasalanceViewer、3D 版或 icSpeech Professional 为选配。 属通用测量仪器,非用于疾病诊断或治疗的医疗器械。
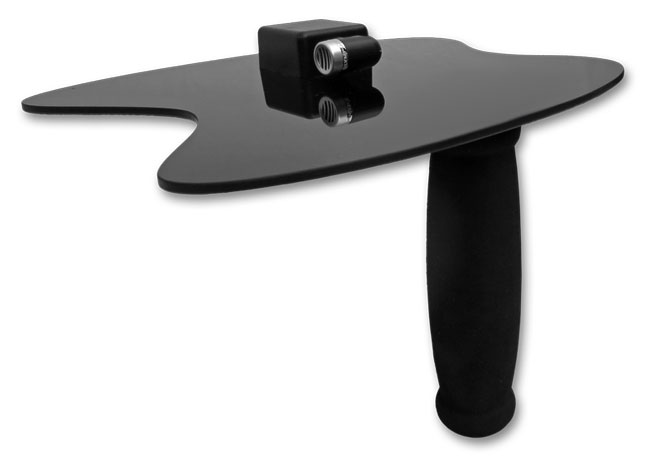
仪器信息
| 品牌 | icSpeech |
|---|---|
| 型号 | Nasality Microphone |
| 分类 | 鼻流计/鼻音计 |
| 仪器编码 | united-kingdom-icspeech-portable-nasometry-system-nasality-microphone |
| 在售状态 | 在售 |
| 地区来源 | 英国 |
| 更新时间 | 2026-10-10 |
| 研究领域 | 言语语言病理学与临床语音学、腭咽功能与共鸣障碍评估、言语声学与语音信号处理、实验语音学与言语产生研究、生物医学仪器与测量验证 |
技术参数
共 50 条规格记录
| 测量对象 | 浊音的鼻音化程度(鼻化度) |
|---|---|
| 口鼻声道分离方式 | 采用置于上唇上方的轻质声学隔离板,配独立的鼻腔与口腔麦克风 |
| 鼻化度计算公式 | 鼻声能量占总声能量的百分比,仅对浊音计算 |
| 可测量参数 | Acoustic nasalance、Nasal acoustic energy、Oral acoustic energy、Total acoustic energy、Voice intensity、Pitch(配 icSpeech Professional Edition 时) |
| 校准要求 | 无需校准 |
| 音频输入通道数 | 2 通道立体声 |
| 声道信号分配 | 鼻腔语音(Nasal speech) |
| 声道信号分配 | 口腔语音(Oral speech) |
| 采样率 | 48/44.1/16/8 kHz |
| 模数转换分辨率 | 16 bit |
| 麦克风频率响应 | 100–15,000 Hz(带通滤波器禁用) |
| 带通滤波范围 | 350–650 Hz(带通滤波器启用) |
| 带通滤波中心频率 | 500 Hz |
| USB 音频适配器频率响应 | 20–20,000 Hz |
| 动态范围 | 96 dB |
| 总谐波失真 | -90 dB |
| 音频输入电平范围 | 0–1.25 Vrms |
| 录音增益范围 | -6–33 dB |
| 麦克风灵敏度 | -40 dB(1 kHz 时,0 dB = 1 V/Pa) |
| 麦克风输出阻抗 | 2.2 kΩ |
| USB 接口版本兼容性 | USB 1.0、2.0、3.0 |
| 传感器线缆接头形式 | 3.5 mm 插头,接入 USB 音频适配器的麦克风输入插孔(粉色标识) |
| 直流供电电压 | 4.5–5.5 V DC(经 USB 供电) |
| 直流供电电流 | 33 mA |
| 麦克风供电电压 | 1.5–10 V |
| 供电方式 | USB 总线供电 |
| 麦克风类型 | 驻极体电容式(Electret condenser) |
| 麦克风指向性 | 单向性(Uni-directional) |
| 麦克风一致性匹配 | 鼻腔与口腔麦克风在制造过程中按灵敏度与频率响应逐只匹配 |
| 隔离挡板规格配置 | 配成人与儿童隔离挡板 |
| 隔离挡板使用方式 | 两面可选,使用时选用最贴合上唇上方面部轮廓的一面 |
| 麦克风防风罩使用要求 | 每位使用者使用一套清洁的麦克风防风海绵 |
| 标准配置清单 | 声学隔离板、麦克风 ×2、麦克风防风海绵 ×4、软胶手柄、USB 音频适配器、USB 数据卡 |
| 可选配件 | 麦克风防风海绵(可另行购买) |
| 配套分析软件 | NasalanceViewer、NasalanceViewer 3D、icSpeech Professional Edition |
| 操作系统兼容性 | Windows 10、Windows 11 |
| 计算机类型兼容性 | 台式机、笔记本电脑、平板电脑 |
| 数据导出格式 | CSV |
| 工作模式 | 实时视觉反馈与录制后离线分析 |
| 生物反馈显示形式 | 实时 Bar 条形显示、实时 Waveform 波形显示(配 icSpeech Professional Edition 时) |
| 言语治疗训练游戏 | 6 款交互式言语治疗游戏,目标与奖励可调(配 icSpeech Professional Edition 时) |
| 整机形态 | 便携式手持设备,配便携箱 |
| 整机形态 | 手持式,非头戴式 |
| 存储温度范围 | < 70 °C(存放于原装便携箱内) |
| 法规符合性声明 | 制造商声明本产品符合欧盟发布的相关指令与标准 |
| 法规符合性声明 | 制造商声明本产品符合在英国(Great Britain)境内销售产品的适用要求 |
| 隔离挡板清洁消毒方式 | 每次使用前用一次性消毒湿巾擦拭声学隔离板两面 |
| 废弃处理要求 | 寿命终止后不得按生活垃圾或一般垃圾处理,应交由适用的电气电子设备回收点,或退回供应商处置 |
| 预期用途 | 通用测量仪器,供言语语言专业人员、研究人员与教育工作者使用;不作为医疗器械使用 |
| 适用场景 | 临床言语治疗或家用发音治疗 |
相关实验室
以下机构来自本仪器关联论文的作者署名,不代表已确认采购或持有该仪器。
兰卡斯特大学
地区:英国
署名作者:玛雅·杜赫斯特、萨姆·柯卡姆
研究方向:鼻音化率、鼻音性、声学、硬件
关联论文 1 篇
瓦伦西亚大学
地区:西班牙
署名作者:克里斯蒂娜·佩里斯-埃尔南德斯
研究方向:鼻音计、鼻音化率、共鸣、3至5岁儿童
关联论文 1 篇
西班牙马拉加大学
地区:西班牙
署名作者:安德烈斯·洛萨诺、伊格纳西奥·莫雷诺-托雷斯
研究方向:言语、语音信号处理、音节、卷积
关联论文 1 篇
辛辛那提大学
地区:美国
署名作者:安·W·库默
研究方向:鼻音计、鼻音化率、共鸣、3至5岁儿童
关联论文 1 篇
实验方法
研究方向:跨语种、跨年龄与性别的鼻音化率常模建立、过高鼻音与腭咽功能障碍的客观筛查与量化、元音负荷与音系环境对鼻音化率的影响、鼻音计硬件的跨仪器比较与验证、基于双通道鼻音计信号的机器学习鼻音化率计算、鼻音测量的组内与组间(单次与多次)信度研究
西班牙语3至5岁儿童鼻音化率(nasalance)常模测定实验
方法说明:该实验使用英国 Rose Medical Solutions 公司的鼻音计(配套 iSpeech Professional Edition 软件,即 icSpeech 鼻音计系统),对西班牙瓦伦西亚市 130 名 3 至 5 岁无言语、语言、听力障碍的正常儿童进行鼻音化率测量。研究者在 MacKay-Kummer 简化鼻音测量评估程序修订版(SNAP-R,2005)的基础上改编出一套西班牙语鼻音评估语料(孤立元音、高压辅音音节、鼻辅音音节与语音平衡短语),逐项采集鼻腔与口腔声能,由仪器计算鼻音化率=鼻腔声能/(鼻腔+口腔声能)×100。实验目的是建立西班牙语儿童的鼻音化率常模阈值,检验年龄与性别对鼻音化率的影响,并验证元音负荷(高元音 /i/ 与低元音 /a/、/o/)对鼻音化率的作用,为同龄过高鼻音及腭咽功能不全患儿提供可比对的参照数据。
实验仪器:鼻音计(鼻流计/鼻音计) icSpeech 鼻音计(NMS);鼻音测量与分析软件 iSpeech Professional Edition;统计分析软件 SPSS Statistics 26;电子表格软件 Excel 365
实验步骤
- 受试者招募与纳入排除筛查
说明:从瓦伦西亚市 Escuela Sedaví 招募 130 名儿童(女 67 名、男 63 名;3 岁 40 名、4 岁 47 名、5 岁 43 名,平均年龄 4.02 岁,标准差 0.802),由学校向家长发放说明信并取得书面知情同意。
关键点:纳入标准为口面部解剖正常且无语言、言语、嗓音、听力或神经障碍;排除采集时存在上呼吸道感染、口面部畸形(唇腭裂、腭咽功能不全、颅面综合征)、发育迟缓、交流障碍或神经系统障碍者;由年度儿科评估结合班主任与心理教育访谈共同判定。
- 鼻音计准备与校准
说明:按厂家说明书使用 Rose Medical Solutions 鼻音计,在每次检查前完成校准,并按附录所列规格与系统要求配置设备。
关键点:校准必须在检查开始之前完成;声学分隔板上方为鼻腔传声器、下方为口腔传声器,两路信号同步采集,是鼻音化率计算准确的前提。
- 西班牙语 SNAP-R 改编语料编制
说明:依据 SNAP Test-R 设计西班牙语测试语料:第一子测验为高压辅音 /p、b、k、s/ 分别与低压元音 /a/ 及高压元音 /i/ 构成的音节重复,并加入鼻辅音 /m、n、ɲ/ 构成的音节;元音单独录制以便与其他语种比较;另编制与英文 SNAP-R 对应的语音平衡短语与句子。
关键点:因受试儿童年龄小、尚不能阅读,语料中不包含朗读段落;短语以图片作提示诱导发音,保证语料与英文原版在结构上尽可能对应。
- 语音样本采集
说明:采集时由一名研究者将声学分隔板贴紧儿童上唇以保证良好密封,另一名研究者负责诱导发音;孤立音要求持续发声 3 至 5 秒,音节重复至数据充满屏幕,语音平衡短语借助图片提示重复 3 遍。
关键点:分隔板与上唇之间必须保持紧密贴合,避免口腔与鼻腔声能互串;每条刺激均要求受试者完整重复,保证每项刺激均有可用样本。
- 鼻音化率计算与数据导出
说明:每条语音样本录制结束后,由 Rose Medical Solutions 鼻音计配套软件 iSpeech Professional Edition 计算鼻音化率分数,随后将数据转入 EXCEL 365 表格。
关键点:鼻音化率由仪器软件按 鼻腔声能/(鼻腔+口腔声能)×100 自动给出,人工不介入计算,保证跨受试者可比性。
- 信度检验与统计分析
说明:用 IBM SPSS Statistics 26 进行分析:以 Cronbach's α 检验内部一致性;抽取 15 名儿童(各年龄组 5 名)在相隔一周的两天、每天各测 2 次,做重复测量的组内与组间信度;按年龄与性别给出均值与标准差;用 Kolmogorov-Smirnov 检验正态性,并采用 t 检验与相关分析判断差异显著性。
关键点:部分数据不服从正态分布,但考虑样本量 N=130,参数检验稳健,仍采用参数检验;常模阈值取“均值+2 倍标准差”,覆盖正态分布 95% 的情形。
实验数据
各刺激项鼻音化率分数(%)
数据来源:Rose Medical Solutions 鼻音计经 iSpeech Professional Edition 软件实时计算并导出至 EXCEL 365
实验样本:元音 /a/ 在 3 岁组为 16(SD 6)、4 岁组 14(SD 5)、5 岁组 19(SD 11);元音 /i/ 在 3 岁组 26(SD 7)、4 岁组 23(SD 9)、5 岁组 33(SD 10)
数据呈现:按年龄分组的均值±标准差表格,并以柱状图对比不同元音、音节的鼻音化率
鼻音化率常模阈值
数据来源:由各刺激项均值与标准差按“均值+2 倍标准差”推算
实验样本:/i/ 的阈值为 3 岁 40、4 岁 41、5 岁 53;/ma/ 的阈值为 3 岁 70、4 岁 70、5 岁 77
数据呈现:与均值表并列的阈值列表,按年龄横向排列
内部一致性系数
数据来源:对全部受试者各组刺激(元音、音节、短语及全协议)的鼻音化率计算 Cronbach's α
实验样本:元音 0.865、音节 0.945、短语 0.891、全协议刺激 0.962
数据呈现:刺激类型与 α 系数的二列表格
组内与组间重复测量信度数据
数据来源:15 名儿童在两天内各进行 2 次完整鼻音评估所得分数
实验样本:第 1 天第 1 次均值 24.238(SD 5.215)与第 2 次 25.424(SD 4.528),t(14)=-1.855,p=0.085;两天之间 r=0.714,p=0.01
数据呈现:含 N、均值、标准差、t 检验与相关系数的信度表
语音平衡短语鼻音化率
数据来源:图片提示下重复 3 遍的西班牙语短语录音经鼻音计计算
实验样本:短语 /p/(pepe pide pipas)3 岁 23(SD 6)、4 岁 21(SD 5)、5 岁 26(SD 5)
数据呈现:按短语与年龄交叉排列的均值(标准差)及阈值表
方法关联论文:西班牙语3至5岁儿童鼻音化率分数与性别、年龄及元音负荷的关系
开源3D打印鼻音计 Nosey 与商用 icSpeech 鼻音计的同任务对比验证实验
方法说明:该实验以英国 icSpeech(Rose Medical Solutions,坎特伯雷)研制的 Nasality Microphone 商用鼻音计作为参照基准,对实验室自研的低成本开源 3D 打印鼻音采集系统 Nosey 进行性能验证。两名男性英语受试者朗读 60 个单音节词构成的词表,词表覆盖 5 个元音与 4 类音系环境(口腔环境、鼻音起首、鼻音收尾+塞音清浊对立),每套词表重复 6 遍,分别用两套设备录音。通过强制对齐提取元音中点的鼻腔与口腔通道强度,按 鼻音化率=鼻腔声能/(鼻腔+口腔声能)×100 计算,再以线性回归与估计边际均值比较两套系统在绝对鼻音化率水平与音系环境对比量级上的差异,从而判断开源硬件能否替代商用鼻音计用于语音学研究。
实验仪器:鼻音计(鼻音传声器) Nasality Microphone(NMS);开源3D打印鼻音采集装置 Nosey;USB 音频接口 Scarlett 2i2;录音软件 Audacity 3.7.0;语音声学分析软件 Praat;强制对齐工具 P2FA;统计分析环境 R(speakr、emmeans 扩展包)
实验步骤
- 开源硬件设计与制作
说明:依照商用鼻音计的基本结构(两只小型传声器分置于声学挡板两侧、挡板固定于手柄)设计 Nosey 的 3D 打印件,并将设计文件以开源硬件形式公开发布。
关键点:声学挡板的隔离效果与手柄握持的稳定性是核心设计点;同时预留传声器型号与打印材料可替换的接口,便于后续定制化测试。
- 受试者与语料准备
说明:招募两名 30 岁出头的男性受试者,其中一人为标准南部英式英语母语者,另一人为带香港粤语影响的标准南部英式英语使用者;编制 60 个英语单音节词的词表,覆盖 kit、dress、trap、strut、face 五个词汇集元音,并分布于 bin、mid、bend、bent 等音系环境。
关键点:词表在元音与音系环境上做交叉平衡,使得两套设备的比较既能看绝对量级差异,也能看环境对比量级是否保持一致。
- 录音系统搭建
说明:icSpeech 设备经 USB 直接连接计算机;Nosey 的两只传声器经 Focusrite Scarlett 2i2 音频接口接入,两通道增益设为相同;录音在 Audacity 3.7.0 中完成并保持录音电平恒定。
关键点:为保证两套系统可比,需去除 icSpeech 传声器上的防风罩,并使 Nosey 两通道增益严格一致、全程不改动录音电平。
- 语音采集
说明:词表通过 PowerPoint 呈现,受试者以固定载体句 I say ___ for us 朗读每个目标词,每套词表重复 6 遍,分别用两套设备完成录制。
关键点:使用固定载体句可控制语调与语速带来的变异;重复 6 遍以获得足够的样本量支撑统计比较。
- 切分、对齐与声学测量
说明:使用 Penn Phonetics Lab Forced Aligner(P2FA)完成转写与强制对齐,再用 R 语言 speakr 包调用 Praat 脚本,在每个元音时长中点提取鼻腔与口腔两通道的强度值。
关键点:统一取元音中点取值可避免过渡段的鼻音耦合干扰;强制对齐保证两套设备录音的取样时点在语音学上对应。
- 鼻音化率计算与统计建模
说明:按 Nasalance = A_n/(A_n+A_o)×100 计算鼻音化率;建立包含音系环境与设备系统交互项、并控制元音的线性回归模型,用 emmeans 包求估计边际均值,成对比较采用 Bonferroni 校正,显著性水平 α=0.05。
关键点:交互项的设置使研究能分别回答两个问题:两套系统的鼻音化率绝对值是否有系统性偏移,以及音系环境造成的鼻音化率差异量级是否在两套系统间保持一致。
实验数据
双通道声学强度值
数据来源:由 icSpeech 鼻音计与 Nosey 分别录制、经 Praat 脚本在元音中点提取的鼻腔与口腔通道强度
实验样本:每个目标词元音中点对应一对(鼻腔强度,口腔强度)数值,两名受试者各 60 词 × 6 次重复 × 2 套设备
数据呈现:按设备与音系环境分面的箱线图/小提琴图
鼻音化率分数(%)
数据来源:按 鼻腔声能/(鼻腔+口腔声能)×100 由两通道强度换算
实验样本:同一受试者同一词在 Nosey 上的鼻音化率较 icSpeech 系统性偏高约 21%~22%
数据呈现:两套系统并排的鼻音化率分布图与估计边际均值误差棒图
系统间差异的统计检验结果
数据来源:线性回归与 emmeans 成对比较输出
实验样本:受试者 1:Nosey 提高 22%(SE=0.0030,t=7.37,p<0.01);受试者 2:Nosey 提高 21%(SE=0.0033,t=6.36,p<0.01)
数据呈现:含效应量、标准误、t 值与 p 值的统计结果表
音系环境对比的量级差异
数据来源:音系环境 × 设备系统交互项的成对比较结果
实验样本:两名受试者的各项校正后 p 值均大于 0.1,即两套系统在音系环境造成的鼻音化率差异上无显著区别
数据呈现:按音系环境分组的系统间差值及置信区间图
方法关联论文:Nosey:用于声学鼻音化测量的开源硬件
基于双通道鼻音计信号的 MFCC 卷积神经网络鼻音化率计算实验
方法说明:该实验使用英国 Rose Medical Solutions 公司的 icSpeech 鼻音计采集双通道(鼻腔/口腔)语音信号,构建来自哥斯达黎加、西班牙、智利三个西班牙语方言区的健康成年女性语料库,并另行采集西班牙马拉加与巴塞罗那的过高鼻音患儿及健康对照的测试语料。研究以 250 毫秒滑动窗口计算 39 维梅尔频率倒谱系数序列作为卷积神经网络的输入,训练出新的鼻音化率指标 mfccNasalance,并与按传统能量比公式计算的 eNasalance 相比较,以言语治疗师的听感鼻音评分为金标准,用 Spearman 相关衡量两种指标的准确性,同时考察训练与测试方言是否一致、语料动态性高低以及卷积核形状和 1×1 逐点卷积等网络配置对准确性的影响。
实验仪器:鼻音计 icSpeech 鼻音计(NMS);语音声学分析软件 Praat;图形处理器 RTX A100;音频特征提取软件库 Librosa(Python)
实验步骤
- 多方言健康语料采集
说明:使用 icSpeech 鼻音计分别在西班牙(50 名)、哥斯达黎加(42 名)、智利(32 名)采集 18 至 30 岁健康年轻女性的双通道语音,构成鼻音程度不同的训练语料(哥斯达黎加鼻音更强,西班牙与智利鼻音较弱)。
关键点:以方言本身的鼻音化差异构造正负类训练数据,是让网络学到鼻音化声学特征而不依赖病例标注的关键设计。
- 临床测试语料采集
说明:在西班牙马拉加与巴塞罗那采集 38 名过高鼻音患儿与 11 名健康对照(4 至 21 岁)的语音,部分患者多次录音,共获得 47 份过高鼻音样本;测试语料包含低动态性的单音节短词与高动态性的句子及交替轮替(diadochokinetic)音节。
关键点:按语料动态性分层设计测试集,用以检验模型在慢速与快速语流条件下的稳健性;研究经马拉加大学伦理委员会批准(编号 67-2023-H)。
- 信号分窗与 MFCC 特征提取
说明:将鼻音计输出的双通道录音切成 250 毫秒、重叠 150 毫秒的窗口;每窗使用 Python 的 Librosa 包计算 39 维 MFCC,帧长 25 毫秒、帧移 10 毫秒。
关键点:MFCC 序列同时保留鼻腔与口腔通道信息,使网络可从倒谱形态而非单纯能量比中推断鼻音化程度。
- 传统 eNasalance 计算作为基线
说明:用 Praat 脚本按标准协议对信号做中心频率 600 Hz、带宽 300 Hz 的滤波,再计算鼻腔均方根能量与鼻腔加口腔总能量之比,得到传统鼻音化率 eNasalance。
关键点:基线与新方法使用同一批鼻音计录音,保证两种指标之间的差异来自算法而非采集设备。
- 卷积神经网络训练
说明:网络采用 16 个滤波器的卷积层、线性激活、批归一化与 Leaky ReLU;遍历 1×1 至 8×8 共 126 种卷积核组合,并比较是否引入 1×1 逐点卷积;按说话人划分,80% 用于训练、20% 用于验证并做 5 折交叉验证,优化器为 Adam(学习率 1e-5),在单块 Nvidia RTX A100 显卡上训练。
关键点:按说话人而非按片段划分训练与验证集,避免同一说话人数据泄漏;系统遍历核形状以分析其对不同动态性语料的影响。
- 听感评分与准确性评估
说明:由两名言语治疗师对每条语料按 3 级鼻音量表评分(0=正常、1=元音鼻化、2=辅音鼻化),分歧由第三位评分者裁定,评分归一化至 0 至 1 并重新编码为 4 级临床分类;以 Spearman 相关衡量 mfccNasalance 与 eNasalance 同听感评分的一致性。
关键点:因 Shapiro-Wilk 检验显示数据不服从正态分布,改用 Spearman 而非 Pearson 相关;并用双因素方差分析检验核形状与 1×1 逐点卷积的效应,用 t 检验比较方言条件。
实验数据
双通道鼻音计语音信号
数据来源:icSpeech(Rose Medical Solutions Ltd.,英国坎特伯雷)鼻音计录制的鼻腔与口腔两路音频
实验样本:三个方言区共 124 名健康成年女性及 49 名临床受试者的双通道录音,涵盖短词、句子与交替轮替音节
数据呈现:双通道波形图与语谱图并排显示
39 维 MFCC 特征序列
数据来源:Python Librosa 包对 250 毫秒窗口(帧长 25 毫秒、帧移 10 毫秒)计算
实验样本:每个 250 毫秒窗口对应一组 39 维 MFCC 向量序列,作为 CNN 输入张量
数据呈现:MFCC 系数热力图
eNasalance 基线鼻音化率
数据来源:Praat 脚本对信号做 600 Hz 中心、300 Hz 带宽滤波后按能量比计算
实验样本:每条语料对应一个 0 至 1 的鼻腔能量占比数值
数据呈现:按受试者组别与语料类型分组的箱线图
听感鼻音评分
数据来源:两名言语治疗师按 3 级量表独立评分,分歧由第三位评分者裁定
实验样本:0=正常、1=元音鼻化、2=辅音鼻化,归一化后重新编码为 4 级临床类别
数据呈现:评分分布直方图与评分者一致性表
模型准确性与配置效应统计结果
数据来源:各 CNN 配置在测试集上的 Spearman 相关系数及方差分析输出
实验样本:同方言条件下 mfccNasalance 准确性高于 eNasalance;对高动态性语料引入 1×1 卷积核显著提升准确性(p<0.001),对低动态性语料则核形状影响显著(p<0.001)
数据呈现:按核形状与语料动态性排列的相关系数矩阵热力图
方法关联论文:利用梅尔频率倒谱系数与卷积神经网络计算鼻化度
主要部件
暂未收录主要部件
相关论文
共 3 篇;当前显示第 1 页
利用梅尔频率倒谱系数与卷积神经网络计算鼻化度
原文题名:Computing nasalance with MFCCs and Convolutional Neural Networks
发表年份:2024
作者:安德烈斯·洛萨诺;恩里克·纳瓦;玛丽亚·多洛雷斯·加西亚·门德斯;伊格纳西奥·莫雷诺-托雷斯
刊源:PLOS ONE
DOI 10.1371/journal.pone.0315452查看论文摘要与书目信息
摘要 · 中文整理:鼻化度是鼻音亢进的重要临床生物标志物,传统上按经鼻发出的声能量与经口鼻发出的总声能量之比计算(eNasalance)。本文提出一种新方法,用以梅尔频率倒谱系数(MFCC)训练的卷积神经网络(CNN)来计算鼻化度(mfccNasalance)。研究从三方面评估 mfccNasalance 的准确度:1)训练与测试数据来自同一方言或不同方言;2)测试数据在动态性上存在差异(如快速产出的交替运动音节与短词);3)采用多种 CNN 配置(卷积核形状以及是否使用 1×1 逐点卷积)。研究录制了来自不同方言健康说话人的双通道鼻流计语音:哥斯达黎加为「更鼻化」,西班牙与智利为「较少鼻化」。CNN 模型的输入为从 250 ms 滑动窗计算的 39 维 MFCC 向量序列。测试数据录制于西班牙,包含短词(非动态)、句子(动态)与交替运动音节(动态)。CNN 模型的准确度定义为该模型输出的 mfccNasalance 与人类专家感知鼻音评分之间的 Spearman 相关。在同方言条件下,无论 CNN 配置如何,mfccNasalance 都比 eNasalance 更准确;使用 1×1 卷积核可提升动态语料的准确度(p < .000),但对非动态语料无效;卷积核形状仅对非动态语料有显著影响(p < .000)。在跨方言条件下,得分显著低于同方言条件,尤以哥斯达黎加数据训练的模型为甚。我们的结论是:mfccNasalance 是 eNasalance 的一种灵活而有用的替代方案;未来研究应探索如何依据目标语音数据的动态性选择最合适的 CNN 模型以优化 mfccNasalance。
原文摘要:Nasalance is a valuable clinical biomarker for hypernasality. It is computed as the ratio of acoustic energy emitted through the nose to the total energy emitted through the mouth and nose (eNasalance). A new approach is proposed to compute nasalance using Convolutional Neural Networks (CNNs) trained with Mel-Frequency Cepstrum Coefficients (mfccNasalance). mfccNasalance is evaluated by examining its accuracy: 1) when the train and test data are from the same or from different dialects; 2) with test data that differs in dynamicity (e.g. rapidly produced diadochokinetic syllables versus short words); and 3) using multiple CNN configurations (i.e. kernel shape and use of 1 × 1 pointwise convolution). Dual-channel Nasometer speech data from healthy speakers from different dialects: Costa Rica, more(+) nasal, Spain and Chile, less(-) nasal, are recorded. The input to the CNN models were sequences of 39 MFCC vectors computed from 250 ms moving windows. The test data were recorded in Spain and included short words (-dynamic), sentences (+dynamic), and diadochokinetic syllables (+dynamic). The accuracy of a CNN model was defined as the Spearman correlation between the mfccNasalance for that model and the perceptual nasality scores of human experts. In the same-dialect condition, mfccNasalance was more accurate than eNasalance independently of the CNN configuration; using a 1 × 1 kernel resulted in increased accuracy for +dynamic utterances (p < .000), though not for -dynamic utterances. The kernel shape had a significant impact for -dynamic utterances (p < .000) exclusively. In the different-dialect condition, the scores were significantly less accurate than in the same-dialect condition, particularly for Costa Rica trained models. We conclude that mfccNasalance is a flexible and useful alternative to eNasalance. Future studies should explore how to optimize mfccNasalance by selecting the most adequate CNN model as a function of the dynamicity of the target speech data.
关键词:言语、语音信号处理、音节、卷积、元音、声学信号、语言、神经网络
研究目标:传统鼻音化率只依赖窄带能量比,既容易受说话人解剖与方言差异干扰,也难以刻画快速语流中的鼻音化动态,与听感判断的一致性有限;研究要解决的是能否用鼻音计双通道信号的倒谱特征结合卷积神经网络得到与专家听感更一致的鼻音化指标,并明确其方言迁移能力与网络配置选择依据。
主要结论:在训练与测试同方言的条件下,mfccNasalance 与专家听感鼻音评分的 Spearman 相关高于传统 eNasalance,且这一优势不依赖具体网络配置;1×1 逐点卷积显著提升高动态性语料(句子、交替轮替音节)的准确性,而卷积核形状只对低动态性的短词有显著影响;跨方言条件下准确性显著下降,尤其是以哥斯达黎加数据训练的模型。因此 mfccNasalance 是传统鼻音化率的有效替代,但需按目标语料的动态性与方言背景选择模型。
创新点:首次将鼻音计输出的双通道信号转换为 MFCC 序列并交由卷积神经网络学习,摆脱了固定窄带能量比的限制;利用方言本身鼻音程度的差异构造训练数据,避开对大规模病例标注的依赖;系统遍历 126 种卷积核组合并单独评估 1×1 逐点卷积,揭示了网络配置与语料动态性之间的匹配规律。
后续建议:纳入男性与更宽年龄段说话人,检验模型在性别与年龄上的泛化能力;构建跨方言自适应或迁移学习方案,缓解跨方言条件下准确性下降的问题;扩大临床样本并与腭咽功能的影像学或鼻咽镜结果对照,验证指标的临床效度;探索按语料动态性自动选择网络配置的自适应框架,减少人工调参;开展多中心、多品牌鼻音计的采集实验,验证方法对采集设备的稳健性
APA 引文:Lozano, A., Nava, E., García Méndez, M. D., & Moreno-Torres, I. (2024). Computing nasalance with MFCCs and Convolutional Neural Networks. PLOS ONE, 19(12), e0315452. https://doi.org/10.1371/journal.pone.0315452
仪器引用:The speech signal was recorded using a Nasometer (icSpeech, Rose Medical Solutions Ltd., Canterbury, UK), which produces two-channel audio signals.
西班牙语3至5岁儿童鼻音化率分数与性别、年龄及元音负荷的关系
原文题名:Nasalance scores in Spanish-speaking children aged 3 to 5 years according to gender, age, and vowel load
发表年份:2024
作者:克里斯蒂娜·佩里斯-埃尔南德斯;比森特·罗塞尔-克拉里;安·W·库默
刊源:Revista de Investigación en Logopedia
DOI 10.5209/rlog.88054查看论文摘要与书目信息
摘要 · 中文整理:鼻音测量是一种无创、易操作的技术,可客观提供言语过程中口腔与鼻腔声能的数据。本研究的目标:一是编制西班牙语测试语料并确定 3 至 5 岁正常西班牙语儿童的鼻音化率常模值,使同龄的过高鼻音与腭咽功能障碍儿童有可比对的参照;二是判定鼻音化率分数是否存在显著的年龄或性别差异;三是检验元音负荷对鼻音化率的影响。研究采集了 130 名无已知言语、语言或听力障碍儿童的数据,按年龄分为三组。研究者在 MacKay-Kummer 简化鼻音测量评估程序修订版(SNAP-R,2005)基础上改编出西班牙语鼻音评估协议,要求全部受试者重复语音刺激。数据使用 icSpeech 鼻音计采集,并记录于 EXCEL 365 表格以供后续分析。由此获得了西班牙语版 SNAP-R 测验的常模数据。结果显示性别之间无显著差异,但年龄之间存在显著差异;同时发现高元音、前元音(尤其是音位 /i/)负荷会提高鼻音化率分数。该协议构建了与英文 SNAP-R 测验相对应的西班牙语语料,并为西班牙语儿童建立了常模。研究确认高元音会导致更高的鼻音化率,因而决定某段语料鼻音化率的是其元音构成,而非语料所属的语言。
原文摘要:Nasometry is a non-invasive, easy-to-use technique that provides objective data regarding the amount of acoustic energy in the oral and nasal cavities during speech. The goal of this study is to create a Spanish passage and determine normative nasalance values for typical Spanish-speaking children, 3 to 5 years of age, that allows us to compare the values in children of the same age who present hypernasality and velopharyngeal dysfunction. Second, to determine if there are significant differences in nasalance scores based on age or gender. Third, to test the impact of vowel load on nasalance scores. Data were collected from 130 children with no known speech, language, or hearing disorder. Participants were organized into three groups according to age. A nasometric assessment protocol for Spanish was developed based on an adaptation of the MacKay-Kummer Simplified Nasometric Assessment Procedures-Revised (SNAP-R; 2005). All participants were required to repeat the speech stimuli. Data were collected using the icSpeech nasometer and were recorded on EXCEL 365 sheets for further analysis. Normative data is now available for a Spanish version of the SNAP-R Test. No significant differences were found between the genders, but significant differences were found based on age. It was also found that a load of high and anterior vowels, especially the phoneme /i/, increased nasalance scores. This protocol created passages in Spanish that mimic the passages of the SNAP-R Test in English. These Spanish passages were normed for Spanish-speaking children. This study confirms that high vowels result in higher nasalance values and therefore, the vowel composition of a specific passage determines the nasalance score, not the language of the passage.
关键词:鼻音计、鼻音化率、共鸣、3至5岁儿童、西班牙语、元音负荷
研究目标:西班牙语儿童缺乏可用的现代鼻音化率常模数据,既有的西班牙语儿童常模来自 20 世纪 70 年代的 TONAR 鼻音计且已不再使用,导致临床上无法为 3 至 5 岁疑似过高鼻音、腭咽功能不全的患儿提供同龄对照;同时年龄、性别与元音负荷对鼻音化率的作用在既往研究中结论不一,需要系统检验。
主要结论:使用 Rose Medical Solutions 鼻音计采集的鼻音数据具有很高的可靠性(全协议 Cronbach's α 为 0.962,组内与组间重复测量均无显著差异且相关显著);3 至 5 岁西班牙语儿童的鼻音化率不存在性别差异,但存在年龄差异,表现为 4 岁时下降、5 岁时回升并高于 3 岁;高元音、前元音尤其 /i/ 会明显抬高鼻音化率,因此决定一段语料鼻音化率的是其元音构成而非语言本身,研究据此给出了西班牙语版 SNAP-R 各刺激项的均值、标准差与正常阈值。
创新点:首次为 3 至 5 岁西班牙语儿童建立与英文 SNAP-R 测验结构对应的西班牙语鼻音评估语料及常模阈值;在 130 名儿童的大样本上验证了该鼻音计的内部一致性与重复测量信度;通过在同一协议内平行设置高元音与低元音刺激,直接分离出元音负荷而非语言差异对鼻音化率的贡献。
后续建议:扩大年龄范围,纳入 6 岁以上儿童及成人,考察鼻音化率随生长发育的完整变化轨迹;纳入腭裂、腭咽功能不全等临床组,检验所建阈值在真实筛查中的灵敏度与特异度;覆盖拉丁美洲等不同西班牙语方言区,验证常模的跨方言适用性;增加朗读段落与自发言语任务,以评估更长、更自然语料上的鼻音化率表现;将本仪器与其他品牌鼻音计做同步对照,给出跨设备的换算关系以便不同中心数据互通
APA 引文:Peris-Hernández, C., Rosell-Clari, V., & Kummer, A. W. (2024). Nasalance scores in Spanish-speaking children aged 3 to 5 years according to gender, age, and vowel load. Revista de Investigación en Logopedia, 14(1), e88054. https://doi.org/10.5209/rlog.88054
仪器引用:The Rose Medical Solutions, Ltd. (2019) nasometer, which is widely used in Europe, was used for data collection in this study. The specification data and system requirements for this nasometer are included in Appendix 1. The nasometer was used according to the manufacturer's instructions and calibration was performed prior to examination. … After the recording of each speech sample, a nasalance score was calculated using the Rose Medical Solutions nasometer software, iSpeech Professional Edition.
使用资料与操作视频
语音及语言软件icspeech介绍
简介:icspeech is flexible speech therapy software that converts spoken words and sounds into graphical displays.By using a standard microphone input or a spare USB port on your PC .You can obtain a wealth of speech information by attaching any combination of the following devices.A microphone, to obtain acoustic pitch voicing and timing information.a webcam for viewing lips teeth jaw tongue and facial muscles....
发布时间:2020-03-12T02:32:38Z